
Andreas HartelNiko Dürr
Sauerkraut statt Burger: Warum deutsche LLMs deutsche Daten brauchen
TL;DR
Für das Pre-Training haben wir uns entschieden, unsere eigene Common Crawl-Filterpipeline für die deutsche Sprache zu implementieren und diese durch frei verfügbare Datensätze und synthetische Daten zu ergänzen. Unser Ziel waren 4 Bill. deutsche Token. Mit den 1,94 Bill. Token, die frei verfügbare Datensätze bieten, war das nicht zu schaffen. Außerdem liefern frei verfügbare Datensätze keine kontinuierlich aktuellen Daten. Deshalb haben wir diese Datensätze um mehr als 2 Bill. deutsche Token ergänzt, die wir selbst kuratiert und generiert haben.
Einleitung
Bei Aleph Alpha möchten wir Sprachmodelle trainieren, die nicht nur bei englischen, sondern auch bei deutschsprachigen Aufgaben überzeugen. Die Modelle sollen also grammatisch korrektes Deutsch schreiben, den deutschen kulturellen Kontext verstehen und die Anwendungsfälle unserer Kunden abdecken. Um solche Modelle zu trainieren, benötigen wir geeignete Trainingsdaten. Wir haben früh festgestellt, dass bestehende frei verfügbare Datensätze allein nicht ausreichen. Synthetische Daten kamen ebenfalls infrage, erwiesen sich aber als schwieriger, als es zunächst klingt. Deshalb haben wir uns entschieden, unsere eigenen organischen Daten zu kuratieren und diese durch frei verfügbare Datensätze sowie synthetische Daten zu ergänzen.
Die Grenzen bestehender frei verfügbarer Datensätze
Ein Spitzenmodell zu trainieren braucht heute über 20 Bill. Token (siehe z. B. Nemotron 3 Super). Unsere Ablationsstudien haben gezeigt, dass ein Anteil von 20 % deutscher Daten für unsere deutschen Benchmarks optimal ist. Daraus ergibt sich eine Untergrenze von 4 Bill. deutschen Token, die für das Training benötigt werden. Gemeint sind dabei Trainings-Token, nicht unterschiedliche Token: Da Datensätze während des Trainings üblicherweise mehrfach wiederholt werden, darf der zugrunde liegende Datenpool kleiner als 4 Bill. sein, wenn auch nicht beliebig klein, weil sich das Wiederholen von Daten nach etwa vier Epochen nicht mehr auszahlt (Muennighoff et al.).
Die folgende Tabelle zeigt einige der bestehenden frei verfügbaren deutschen Datensätze. Wie man sieht, kommen sie zusammen auf rund 1,94 Bill. Token. Wir listen diese Datensätze auf, um die Lücke zwischen den verfügbaren offenen Datensätzen und der Menge an deutschen Daten, die wir für das Training unserer Modelle benötigen, zu veranschaulichen, ohne zu implizieren, dass wir unsere Modelle auf diesen offenen Datensätzen trainiert haben.
| Datensatz | Größe (Mrd. Token) | Neueste Quelldaten |
|---|---|---|
| KletterMix (maschin. Übersetzung von ClimbMix) | 500 | 2024 |
| HPLT 3.0 (deutscher Anteil) | 609 | 2025 |
| FinePDFs (deutscher Anteil) | 177 | 2025 |
| German Commons | 154 | 2025 |
| MT-Nemotron-CC (maschin. Übersetzung von Nemotron-CC) | 117 | 2024 |
| FineWeb2 (deutscher Anteil) | 378 | 2024 |
Frei verfügbare deutsche Datensätze, ihre Größe und das Jahr des letzten Crawls bzw. der letzten Quellversion, die sie enthalten. Die Token-Zahlen sind Schätzungen (unkomprimierte Größe in Byte geteilt durch 4), damit die Datensätze vergleichbar sind.
Zwei Einschränkungen machen aus den 1,94 Bill. eine Obergrenze. Erstens handelt es sich bei KletterMix und MT-Nemotron-CC, die zusammen etwa 600 Mrd. Token umfassen, um maschinelle Übersetzungen englischer Korpora. Welche Probleme das mit sich bringt, besprechen wir im nächsten Abschnitt. Zweitens stammen HPLT, FineWeb2 und German Commons alle aus Common Crawl und überschneiden sich erheblich, sodass sich ihre Größen nach der Deduplizierung nicht einfach aufsummieren lassen.
Unsere eigene Kuratierungspipeline lieferte rund 1,3 Bill. Token, was uns zusammen mit unseren eigenen synthetischen Daten unserem Ziel deutlich näher bringt. Dies wird in der folgenden Abbildung veranschaulicht.
- HPLT 3.0 (dt. Anteil)609 Mrd. · 31%
- KletterMix (dt. ClimbMix)500 Mrd. · 26%
- FineWeb2 (dt. Anteil)378 Mrd. · 20%
- FinePDFs (dt. Anteil)177 Mrd. · 9%
- German Commons154 Mrd. · 8%
- MultiSynt / MT-Nemotron-CC117 Mrd. · 6%
Sechs frei verfügbare deutsche Datensätze bzw. deutsche Anteile summieren sich auf ~2 Bill. Token.
Ein weiteres Problem bei frei verfügbaren Datensätzen ist, dass es sich um Momentaufnahmen handelt. Jeder Datensatz wird aus Crawls bis zu einem festgelegten Datum zusammengestellt und anschließend eingefroren; FineWeb2 enthält beispielsweise keine Daten, die nach April 2024 gecrawlt wurden. Ein darauf trainiertes Modell ohne Retrieval oder Tool-Zugriff antwortet auf die Frage nach dem Bundeskanzler daher voller Überzeugung mit „Olaf Scholz“. Neuere Veröffentlichungen rücken den Stichtag zwar näher an die Gegenwart, jedoch immer mit einer Verzögerung von vielen Monaten und nur, wenn die Herausgeber eine neue Version nachlegen. Wenn wir wollen, dass unsere Modelle über aktuelles Weltwissen verfügen, können wir uns nicht auf diesen Rhythmus verlassen. Mit einer eigenen Common-Crawl-Kuratierungspipeline können wir unseren Datensatz mit jedem neuen Crawl erweitern, sobald dieser erscheint.
Die Grenzen synthetischer Daten
Synthetische Daten sind eine natürliche Ergänzung zu organischen Daten und Teil unseres Datenmixes. Allerdings sind synthetische Daten nur so gut wie das Modell, das sie erzeugt. Wissen, Wissenslücken und Alignment dieses Modells fließen in die Trainingsdaten ein und von dort in unsere eigenen Modelle. Darum wählen wir sorgfältig aus, welche Modelle wir hierfür verwenden. Wir bevorzugen Open-Weights-Modelle, die wir auf unserer eigenen Infrastruktur ausführen können. In diesem Rahmen nutzen wir synthetische Daten für zwei Dinge: die Umformulierung bestehender deutscher Dokumente und die Übersetzung von Dokumenten aus anderen Sprachen. Beide Ansätze haben ihre Grenzen, auf die wir im Folgenden eingehen.
Beginnen wir mit der Umformulierung. Dabei schreibt ein LLM ein bestehendes organisches Dokument um, etwa in einen Lexikoneintrag, einen Frage-Antwort-Dialog oder eine Lehrbuchpassage, und behält dabei den Inhalt bei. Da das Modell nur das umformuliert, was bereits vorhanden ist, muss es deutlich weniger können: Es benötigt kein tiefgreifendes deutsches Weltwissen, sondern lediglich gute Deutschkenntnisse. Das Umformulieren ist wertvoll, weil es dem Modell dieselben Fakten in vielen verschiedenen Formulierungen beibringt, was die Generalisierungsfähigkeit verbessert, und weil es knappe organische Daten praktisch vervielfacht. Und Knappheit ist genau unser Problem im Deutschen. Open-Weights-Modelle erfüllen diese Anforderungen und kamen bei uns entsprechend zum Einsatz: Für Aleph-Alpha-GermanWeb entstanden durch Umformulierung deutscher Texte von FineWeb2 etwa 1 Bill. Token. Allerdings vervielfacht Umformulierung nur, was schon da ist: Neues Wissen entsteht nicht, und der Vorrat an deutschen Ausgangstexten bleibt begrenzt.
Mit LLMs lassen sich auch Daten aus dem Englischen oder anderen Sprachen ins Deutsche übersetzen. Wir haben festgestellt, dass die LLM-basierte Übersetzung von Datensätzen funktionieren kann, mit dem richtigen Modell und der richtigen Kombination aus Prompts und Chunking-Strategie, also der Art, wie ein langes Dokument in Stücke zerlegt wird, die das Modell nacheinander übersetzt. Allerdings weist die maschinelle Übersetzung zwei Probleme auf. Erstens: Die Ausgabe ist meist grammatisch korrekt, rutscht aber gelegentlich ins sogenannte „Translationese“ ab, die Tendenz, Redewendungen wörtlich von einer Sprache in eine andere zu übersetzen (z. B. könnte „Drive safe!“ mit „Fahre sicher!“ übersetzt werden, anstatt mit dem passenderen „Komm gut an!“).
Das zweite Problem: Der kulturelle Kontext wird nicht mitübersetzt. Wenn es auf einer englischen Website um Hauskauf in Miami oder Burgerbestellungen geht, handelt das übersetzte Dokument nicht plötzlich von Wohnungen in Berlin oder einer Bestellung von „Sauerkraut und Schupfnudeln“. Das ist an sich kein Problem. Ein deutsches Modell profitiert genauso von Wissen über Miami, Jakarta oder Buenos Aires wie ein englisches, und ein Korpus, das viele kulturelle Perspektiven enthält, ist eine Stärke. Das Problem liegt in der Verteilung. Ein aus dem Englischen übersetztes Korpus übernimmt die geografische, demografische und institutionelle Schlagseite des englischsprachigen Webs, sodass ein Modell, das überwiegend darauf trainiert wurde, lernt, auf Deutsch über eine Welt zu sprechen, die amerikanisch aussieht. Aktuelle Arbeiten zu synthetischen Personas zeigen dasselbe von der anderen Seite: Pleias und NVIDIA stützen ihre Nemotron-Personas-Datensätze auf nationale Volkszählungsstatistiken, gerade weil ein Datensatz systematisch verzerrte Ergebnisse liefert, wenn er die Bevölkerung falsch abbildet, für die das Modell gedacht ist, und die US-Ausgabe zeigt, wie stark solche Daten an ihren Ursprung gebunden bleiben.
Man kann einwenden, dass sich Wissen zwischen Sprachen überträgt; so argumentieren etwa die Autoren von ÜberWeb. Doch sowohl ihre Arbeit als auch die neuere Arbeit von Gaber et al. deuten darauf hin, dass eine sorgfältige mehrsprachige Kuratierung und möglicherweise gezielte Übersetzungen erforderlich sind, um einen optimalen Sprachtransfer zu erreichen, ohne dabei die Leistung in den einzelnen Sprachen zu beeinträchtigen.
Unterm Strich bleibt synthetischen Daten damit eine Nebenrolle. Die Umformulierung hat gut funktioniert und uns etwa 1 Bill. Token geliefert, kann jedoch lediglich die bereits vorhandenen organischen deutschen Daten vervielfachen. Eine Übersetzung ist technisch machbar, übernimmt jedoch die Verteilung der Ausgangssprache. Keiner der beiden Ansätze ersetzt organische deutsche Webdaten; beide setzen sie voraus. Deshalb haben wir uns entschieden, eine eigene Kuratierungspipeline basierend auf Common Crawl aufzubauen.
Unsere eigene Pipeline
Unser Ausgangspunkt war eine Webdaten-Pipeline, ähnlich der im Olmo-3-Tech-Report beschriebenen, die dort einen rein englischen Datensatz kuratiert hat. Es hat sich jedoch herausgestellt, dass ein solches Pipeline-Konzept nicht eins zu eins auf eine andere Sprache übertragen werden kann, ohne zu viele wertvolle Daten zu verlieren. Außerdem wollen wir – Stichwort veraltetes Wissen – neue Crawls verarbeiten können, sobald sie erscheinen. In diesem Blogbeitrag konzentrieren wir uns darauf, warum und wie wir unsere Common-Crawl-Pipeline an die deutsche Sprache angepasst haben. In einem zukünftigen Blogbeitrag werden wir die technischen Herausforderungen beleuchten, die mit dem Aufbau einer Datenkuratierungs-Pipeline in Web-Größenordnung einhergehen.
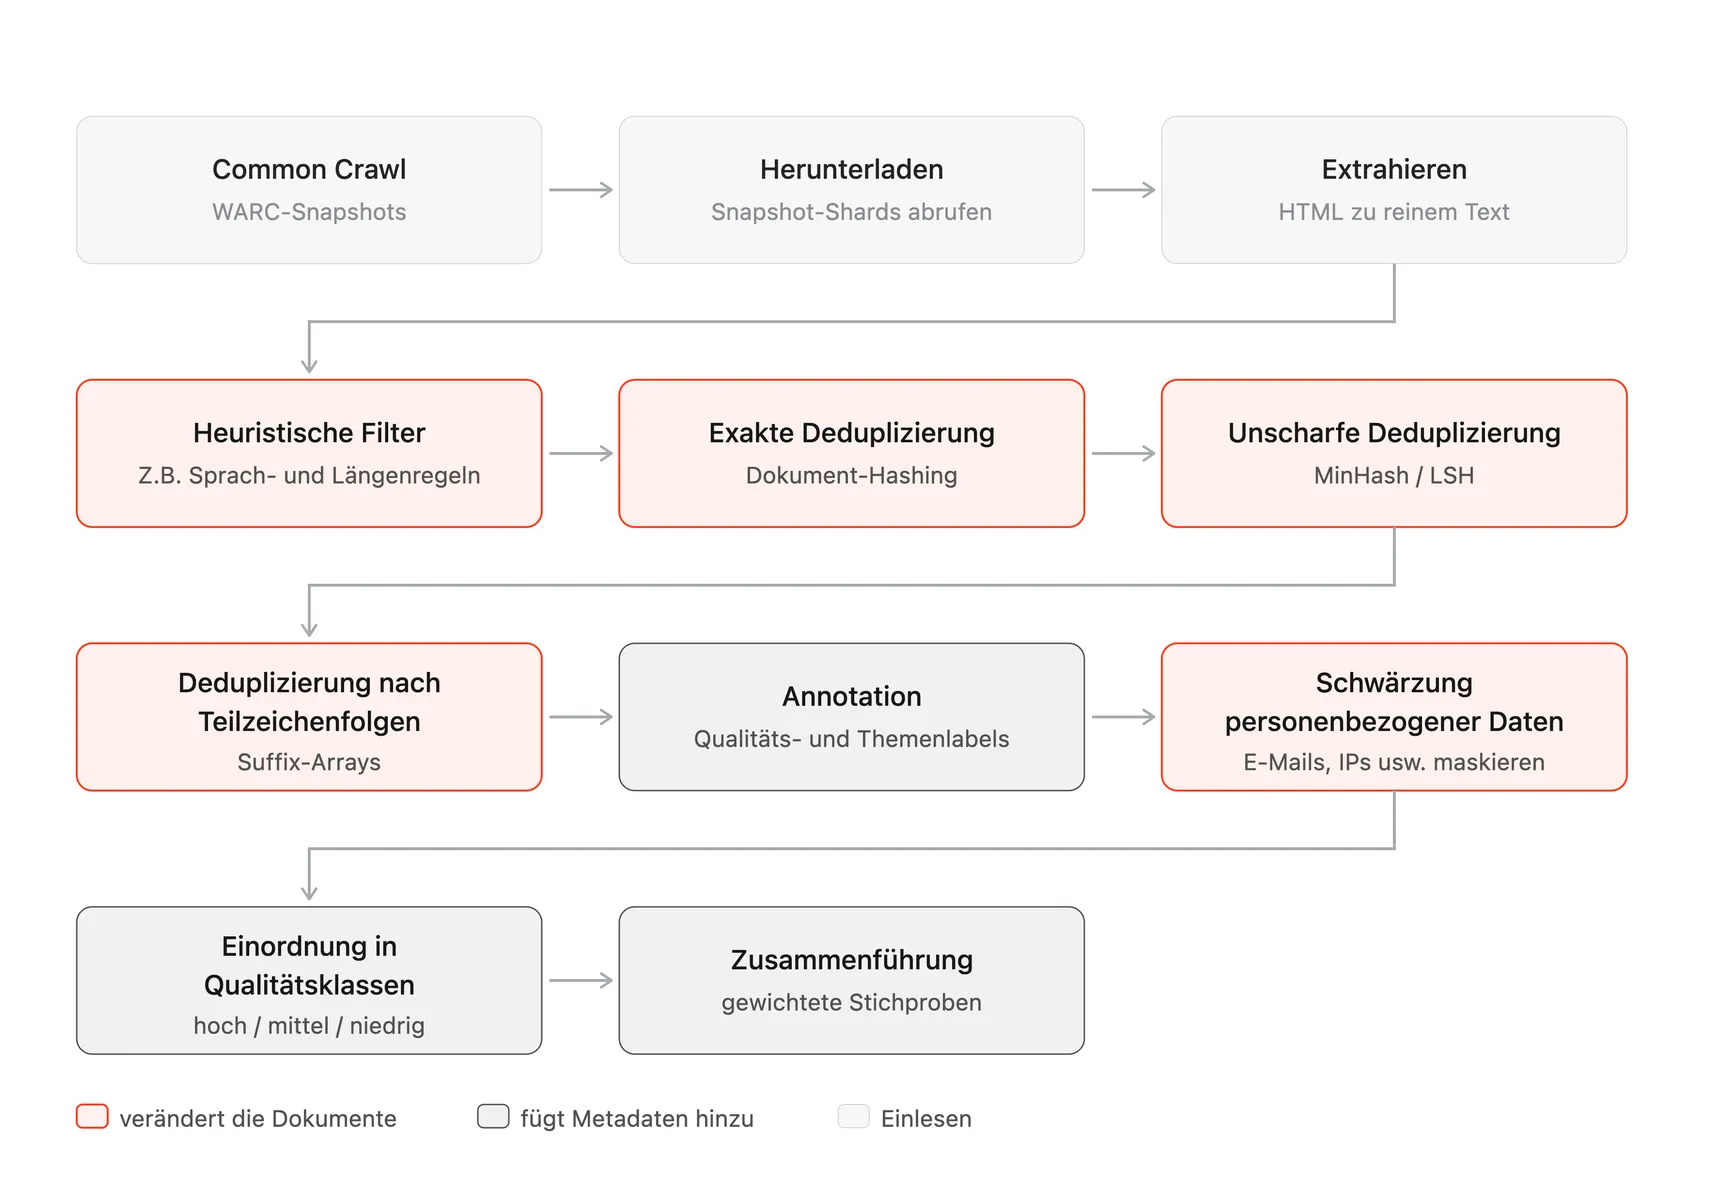
Die obige Abbildung zeigt die elf Stufen, die unsere Daten durchlaufen, vom rohen Common-Crawl-Snapshot bis zum endgültigen Trainingsmix. Nach dem Herunterladen und Extrahieren des Textes aus den WARC-Dateien werden mithilfe einer URL-Blockliste und einer Reihe sprachspezifischer heuristischer Filter gesperrte Domains und offensichtlich unbrauchbare Inhalte entfernt. Drei Deduplizierungsstufen (exakt, unscharf und Teilzeichenfolge) entfernen anschließend redundante Inhalte mit zunehmender Granularität. Die verbleibenden Dokumente werden mit Qualitätsbewertungen versehen und nach Themen klassifiziert, personenbezogene Daten (PII) werden durch spezielle Token ersetzt, und die Dokumente werden in Qualitätsklassen sortiert, die schließlich bestimmen, wie sie in den Trainingsdaten gemischt und wie oft sie wiederholt werden.
Neben den einzelnen Stufen bestimmen ein paar Grundprinzipien die Pipeline als Ganzes. Erstens ist sie inkrementell: Neue Common-Crawl-Snapshots können hinzugefügt werden, sobald sie erscheinen, ohne dass alles Vorhergehende erneut verarbeitet werden muss. Das ist die Lösung für das zuvor erörterte Problem des veralteten Wissens. Zweitens ist sie speichereffizient: Jede Stufe speichert nur, was sich geändert hat, anstatt eine vollständige Kopie der Daten zu erstellen, sodass elf Stufen nicht elf vollständige Kopien der Daten erfordern. Drittens ist sie rückverfolgbar: Für jedes Dokument im endgültigen Trainingsmix kennen wir die Quell-URL, den Crawl und jede Entscheidung, die auf dem Weg getroffen wurde. Wenn wir später Probleme in unseren Trainingsdaten feststellen, können wir deren Ursprung identifizieren und sie an der Quelle beheben, statt sie erst später im Prozess zu korrigieren. Viertens ist sie nach Sprache parametrisiert: Schwellenwerte, Wortlisten und Klassifikatoren sind konfigurierbar. So kam Deutsch neben Englisch dazu, und so werden weitere Sprachen dazukommen. Schließlich sind Datenschutz und Qualität in die Pipeline integriert: Die Ersetzung personenbezogener Daten und die URL-Filterung sind feste Stufen, Qualitätsannotationen fließen in den endgültigen Trainingsmix ein, und die Schwellenwerte der Filter legen wir anhand von Ablationsstudien auf unseren deutschen Benchmarks fest.
Es gibt bereits über 120 Common-Crawl-Snapshots, und etwa monatlich kommt einer dazu. Wir wollen sie in unsere Datensätze aufnehmen, sobald sie erscheinen, und jeder neue Crawl bringt rund 100 Mio. deutsche Dokumente mit, etwa 50 Mrd. Token. Das sind allerdings Rohzahlen: Die Deduplizierung und die heuristische Filterung erfolgen in nachgelagerten Schritten und werden diese Zahl erheblich verringern. Dies ist eine der zentralen Herausforderungen der Datenkuratierung: Jeder Filterschritt erhöht die Qualität auf Kosten der Menge.
Die Deduplizierung ist ein typisches Beispiel dafür. Wir deduplizieren auf drei Ebenen: Die exakte Deduplizierung entfernt byteweise identische Dokumente, die unscharfe Deduplizierung (MinHash) entfernt Beinahe-Duplikate wie etwa denselben Artikel mit unterschiedlichen Kopf- oder Fußzeilen, und die Teilzeichenfolgen-Deduplizierung entfernt lange wiederholte Passagen innerhalb ansonsten unterschiedlicher Dokumente, z. B. gleichlautende Disclaimer oder Navigationstexte. Bei unseren organischen Webdaten im Pre-Training tun wir dies teilweise aus Effizienzgründen: Jedes Duplikat kostet einen Trainingsschritt, in dem das Modell nichts Neues lernt. Während des Mid-Trainings deduplizieren wir alle Datensätze – einschließlich der frei verfügbaren. Einige frei verfügbare Datensätze enthalten, wie sich herausstellt, mehr als 50 % exakte Duplikate (die „hochwertige“ Teilmenge von Nemotron-Math-v2 ist ein Beispiel dafür), was den Datenmix unbemerkt verzerrt. Muennighoff et al. zeigten, dass die Wiederholung von Daten nur bis zu einem gewissen Punkt vorteilhaft ist und der Nutzen nach etwa vier Epochen abnimmt. Wenn wir hochwertige Daten gezielt mehrfach wiederholen wollen, müssen wir wissen, wie oft das Modell jedes Dokument tatsächlich sieht, und dafür brauchen wir eine deduplizierte Ausgangsbasis.
Unser übergeordnetes Ziel ist es, aus jedem Crawl so viele hochwertige Daten wie möglich zu extrahieren, daher muss jeder heuristische Filter für Deutsch neu abgestimmt werden. Zwei Beispiele zeigen, wie unterschiedlich groß der Effekt sein kann: der Wortlängen-Filter, bei dem die englischen Schwellenwerte einen bescheidenen, aber vermeidbaren Verlust von 300.000 Dokumenten pro Crawl verursachen, und der Stoppwort-Filter, bei dem sie den Großteil des deutschen Webs wegwerfen würden.
Der Wortlängen-Filter behält ein Dokument, wenn dessen durchschnittliche Wortlänge
innerhalb von [word_len_lower, word_len_upper] liegt. Warum Deutsch
und Englisch hier verschiedene Schwellenwerte brauchen, zeigt ein Auszug aus einem kommunalen
Merkblatt zur Wohnsitzanmeldung:
Der deutsche Auszug ist typisches Behördendeutsch, doch seine durchschnittliche Wortlänge (11,7 Zeichen) ist mehr als doppelt so hoch wie die der englischen Übersetzung (5,7 Zeichen) und liegt außerhalb der von Gopher festgelegten englischen Grenzen von 3 bis 10. Mit dem von FineWeb2 für „deu_Latn“ vorgeschlagenen Intervall [0, 15] sinkt die Ausschussrate bei deutschen Daten von 0,3 % auf 0,02 %. Klingt wenig, aber bei rund 100 Mio. deutschen Dokumenten pro Crawl sind das 300.000 ganz normale deutsche Dokumente, die wir behalten statt wegwerfen.
Der Stoppwort-Filter behält ein Dokument, das mindestens zwei Wörter aus einer
kurzen Liste von sehr häufig vorkommenden Funktionswörtern enthält. Die englische Liste
entspricht der Gopher-Liste: {the, be, to, of, and, that, have, with}. Die deutsche Liste wurde von FineWeb2 vorgeschlagen und sieht wie folgt aus:
der, die, das, den, dem, des, und, in, im, von, mit, als, er, wurde, für
Der Effekt ist hier weitaus drastischer: Auf deutsche Dokumente angewandt, sortiert die englische Stoppwortliste mehr als 87 % der Dokumente aus, die diese Stufe der Pipeline erreichen, gegenüber 0,6 % mit der deutschen Liste, also rund 150-mal so viele. Mit anderen Worten: Ohne diese einzige Anpassung würden wir sieben von acht deutschen Dokumenten verwerfen.
Wie sieht ein deutsches Dokument aus, das die englische Filterliste passiert? Hier eines, das durchgekommen ist: eine CORDIS-Projektseite, deren englische Projektzusammenfassung die Stoppwörter enthält, nach denen der Filter sucht. Der Text wird so wiedergegeben, wie er die Extraktionsstufe verlassen hat, samt Navigations-Boilerplate.
Beispiel: ein deutsches Dokument, das die englische Stoppwortliste passiert hat
Quelle: cordis.europa.eu/project/id/694452/de
Skip to main content
(öffnet in neuem Fenster)
de
CORDIS - Forschungsergebnisse der EU
CORDIS

Flow physics and interaction of laminar-turbulent transition and flow separation studied by direct numerical simulations

Projektbeschreibung

DE EN ES FR IT PL

Fortgeschrittene Simulationen könnten Aufschluss über veränderte Strömungsablösung geben

Die Forschenden des vom Europäischen Forschungsrat finanzierten Projekts TRANSEP werden sich mit den Problemen der numerischen Strömungsmechanik bei der Vorhersage der komplexen Strömungsphysik im Zusammenhang mit dem Übergang von Laminar- zu Turbulenzströmungen und der Strömungsablösung befassen. Durch den Einsatz von Datenverarbeitung im Multi-Peta-Maßstab werden die Forschenden rechnergestützte Methoden erarbeiten, mit denen diese komplexen Strömungsphänomene vorhergesagt, verstanden und gesteuert werden können. Bei den vorgeschlagenen Forschungsarbeiten werden das unerwartete Verhalten laminarer Bereiche an Tragflächen, die dramatischen Veränderungen in laminar-turbulenten Übergangs- und Ablösungsregionen an instationären Tragflächen und die komplexe Interaktion mehrerer Trennungs- und Ablösungsregionen an Hochauftriebsflügelkonfigurationen beleuchtet.

Ziel

The vision spelled out in this proposal is to overcome the failure of Computational Fluid Dynamics to tackle one of the central unsolved fluid physics problems, namely predicting the sensitive flow physics associated with laminar-turbulent transition and flow separation. A recent, highly influential report by NASA (Slotnick et al., 2014) clearly states that the major shortcoming of CFD is its “… inability to accurately and reliably predict turbulent flows with significant regions of separation”, most often associated with laminar-turbulent transition.

The research proposed here will address this shortcoming and develop and utilize computational methods that are able to predict, understand and control the sensitive interplay between laminar-turbulent transition and flow separation in boundary layers on wings and other aerodynamic bodies.

We will be able to understand enigmas such as the recent results from the experiments of Saric et al. at the Texas A&M Univeristy where the laminar area of a wing grows after a smooth surface have been painted (increased roughness), or the drastic changes of laminar-turbulent transition and separation locations on unsteady wings, or the notoriously difficult interaction of multiple separation and transition regions on high-lift wing configurations. For such flows there have been little understanding of flow physics and few computational prediction capabilities. Here we will perform simulations that give completely new possibilities to visualize, understand and control the flow around such wings and aerodynamic bodies, including the possibility to compute and harness the flow sensitivities.

We will tackle these outstanding flow and turbulence problem using the new possibilities enabled by multi-peta scale computing.

Wissenschaftliches Gebiet (EuroSciVoc)

CORDIS klassifiziert Projekte mit EuroSciVoc, einer mehrsprachigen Taxonomie der Wissenschaftsbereiche, durch einen halbautomatischen Prozess, der auf Verfahren der Verarbeitung natürlicher Sprache beruht. Siehe: Das European Science Vocabulary.

Sie müssen sich anmelden oder registrieren, um diese Funktion zu nutzen

Programm/Programme

Mehrjährige Finanzierungsprogramme, in denen die Prioritäten der EU für Forschung und Innovation festgelegt sind.

Thema/Themen

Aufforderungen zur Einreichung von Vorschlägen sind nach Themen gegliedert. Ein Thema definiert einen bestimmten Bereich oder ein Gebiet, zu dem Vorschläge eingereicht werden können. Die Beschreibung eines Themas umfasst seinen spezifischen Umfang und die erwarteten Auswirkungen des finanzierten Projekts.

Finanzierungsplan

Finanzierungsregelung (oder „Art der Maßnahme“) innerhalb eines Programms mit gemeinsamen Merkmalen. Sieht folgendes vor: den Umfang der finanzierten Maßnahmen, den Erstattungssatz, spezifische Bewertungskriterien für die Finanzierung und die Verwendung vereinfachter Kostenformen wie Pauschalbeträge.

ERC-ADG - Advanced Grant

Alle im Rahmen dieses Finanzierungsinstruments finanzierten Projekte anzeigen

Aufforderung zur Vorschlagseinreichung

Verfahren zur Aufforderung zur Einreichung von Projektvorschlägen mit dem Ziel, eine EU-Finanzierung zu erhalten.

(öffnet in neuem Fenster) ERC-2015-AdG

Alle im Rahmen dieser Aufforderung zur Einreichung von Vorschlägen finanzierten Projekte anzeigen

Gastgebende Einrichtung

KUNGLIGA TEKNISKA HOEGSKOLAN
Netto-EU-Beitrag

Finanzieller Nettobeitrag der EU. Der Geldbetrag, den der Beteiligte erhält, abzüglich des EU-Beitrags an mit ihm verbundene Dritte. Berücksichtigt die Aufteilung des EU-Finanzbeitrags zwischen den direkten Begünstigten des Projekts und anderen Arten von Beteiligten, wie z. B. Dritten.
€ 2 097 520,00
Adresse
BRINELLVAGEN 8
100 44 STOCKHOLM
Schweden

Auf der Karte ansehen
Region
Östra Sverige Stockholm Stockholms län
Aktivitätstyp
Higher or Secondary Education Establishments
Links
Gesamtkosten

Die Gesamtkosten, die dieser Organisation durch die Beteiligung am Projekt entstanden sind, einschließlich der direkten und indirekten Kosten. Dieser Betrag ist Teil des Gesamtbudgets des Projekts.
€ 2 097 520,00

Begünstigte (1)

Herunterladen Den Inhalt der Seite herunterladen

Letzte Aktualisierung: 27 Juli 2023

Mein Booklet

Permalink: https://cordis.europa.eu/project/id/694452/de

European Union, 2026

Mein Booklet 0 0
Die heuristischen Filter waren nicht die einzige Stufe, die eine sprachspezifische Anpassung erforderte. Auch die Qualitätsklassifikatoren, die jedem Dokument Bewertungen für Qualitäts- und Themenkategorien zuweisen, mussten angepasst werden, um der deutschen Grammatik und den kulturellen Besonderheiten Rechnung zu tragen. In unserer Veröffentlichung zu Aleph-Alpha-GermanWeb gehen wir darauf ein; eine ausführliche Darstellung würde den Rahmen dieses Beitrags sprengen.
Compliance und Datenschutz
Um zu verhindern, dass das Modell mit illegalen, urheberrechtsverletzenden oder raubkopierten Inhalten trainiert wird, filtern wir unsere Daten anhand einer URL-Filterliste.
Zum Schutz der Privatsphäre ersetzen wir vor dem Training personenbezogene Daten durch spezielle Token. Dazu gehören unter anderem persönliche Kontaktdaten wie E-Mail-Adressen und Telefonnummern, IP-Adressen und Bankkontonummern. Bei E-Mail-Adressen gilt das nicht nur für die übliche Schreibweise mit dem „@“-Trennzeichen, sondern auch für verschleierte Varianten wie „name [at] domain“. Diese Schreibweise verwenden Nutzer gerade deshalb, damit Bots die Adresse nicht abgreifen, und für uns war das ein Grund mehr, diese Absicht zu respektieren. Sowohl die URL-Filterung als auch die Ersetzung personenbezogener Daten spiegeln unsere rechtlichen Verpflichtungen und Compliance-Vorgaben wider, insbesondere im Rahmen der EU-KI-Verordnung.
Diese Maßnahmen können mit Einbußen bei der Qualität verbunden sein, und wir wollten diesen Kompromiss bewusst eingehen. Wir haben daher spezielle Benchmarks entwickelt, die testen, wie gut ein Modell mit PII-ähnlichen Entitäten umgeht. So sollte es beispielsweise weiterhin erkennen können, aus welchem Land eine Telefonnummer stammt, oder ob eine Zeichenfolge eine gültige IBAN ist. Bei diesen PII-Benchmarks schneidet unser Modell um 5 Prozentpunkte schlechter ab als ein Modell, das mit denselben Daten ohne PII-Ersetzung trainiert wurde. Das ist erwartbar, denn es hat im Training nie echte PII gesehen. Alle anderen Benchmarks blieben unverändert. Wir halten dies für einen akzeptablen Preis für ein Modell, das sich keine personenbezogenen Daten merkt.
Contact Jane at jane.doe@example.com and John at john.doe[at]example.com or call +49 30 1234 5678 to confirm the wire to DE89 3704 0044 0532 0130 00. Server at 8.8.8.8 logged an error overnight.
Jeder Detektor ersetzt seine Treffer durch ein Platzhalter-Token. Gestrichelt unterstrichen ist, was erkannt wurde, aber noch im Klartext steht.
[at]-verschleierte – werden vom selben Detektor erfasst.Evaluation
Benchmarks leiden unter derselben Knappheit wie Trainingsdaten, denn sie sind im Grunde selbst kleine, spezialisierte Datensätze. Wir nutzen sie, um Datenrezepte zu vergleichen und um zu prüfen, ob das fertige Modell die Anwendungsfälle unserer Kunden abdeckt. Öffentliche Benchmarks für Deutsch allein bieten weder eine ausreichende Abdeckung realistischer deutscher Aufgaben noch genügend Trennschärfe, um den Mehrwert unserer deutschen Daten nachzuweisen. Wir haben daher eine spezielle deutsche Evaluationssuite entwickelt, teils von Hand erstellt, teils modellgeneriert, um die Leistung auf den eigentlichen Aufgaben zuverlässig zu messen.
Diese Benchmarks sind jedoch nur dann aussagekräftig, wenn ihr Inhalt nicht in die Trainingsdaten gelangt. Webweite Crawls enthalten fast zwangsläufig Kopien beliebter Benchmarks, und ein darauf trainiertes Modell glänzt zwar mit beeindruckenden Werten, bleibt jedoch bei den realen Anwendungsfällen, die uns und unseren Kunden tatsächlich wichtig sind, hinter den Erwartungen zurück. Deshalb dekontaminieren wir unsere Datensätze gegen alle Benchmarks, auf denen wir evaluieren. In Anlehnung an den Ansatz von AI2 für Olmo 3 wenden wir die Dekontamination derzeit nur auf unsere Daten im Mid-Training (zweite Stufe) an, planen jedoch, sie in Zukunft auf das Pre-Training auszuweiten.
Fazit
In diesem Blogbeitrag haben wir beschrieben, warum und wie wir unsere Webdaten-Pipeline an die deutsche Sprache angepasst haben. In Zukunft werden wir mit derselben Sorgfalt und Liebe zum Detail auch andere Sprachen angehen. Unsere Pipeline ist bereits sprachparametrisiert: Deutsch war die erste Sprache, die wir neben Englisch hinzugefügt haben, und die daraus gewonnenen Daten bieten den Mehrwert, den unsere Kunden benötigen. Insgesamt haben wir bislang mehr als 2 Bill. hochwertige deutsche Token kuratiert und generiert. Wir ergänzen sie durch bestehende frei verfügbare Datensätze, und unsere Ablationsstudien zeigen, dass sie sich bedenkenlos mehrfach wiederholen lassen, um die Leistung auf den eigentlichen Aufgaben zu verbessern.
Danksagungen
Die hier beschriebene Pipeline und die Datensätze sind das Ergebnis von Teamarbeit. Unser Dank gilt dem gesamten Datenteam bei Aleph Alpha Research, insbesondere Ivo Schaper, Peter Rodenkirch Nfissi, Fabian Gebhart, Bastian Harren, Tom Burns, Mohamed Soliman, Denis Waßmann und Lukas Schott, deren Arbeit in jeder Stufe dieser Pipeline steckt. Wir danken Yasser Jadidi, Fabien Benureau, Michael Hofmann, Noé Beckerle Vallejo, Helena Treeck und Paige Reddington für ihre sorgfältigen Reviews und ihr wertvolles Feedback zu diesem Blogpost, Svenja Fahlisch für die Koordination und Finn Kiesinger für die Veröffentlichung auf der Website.